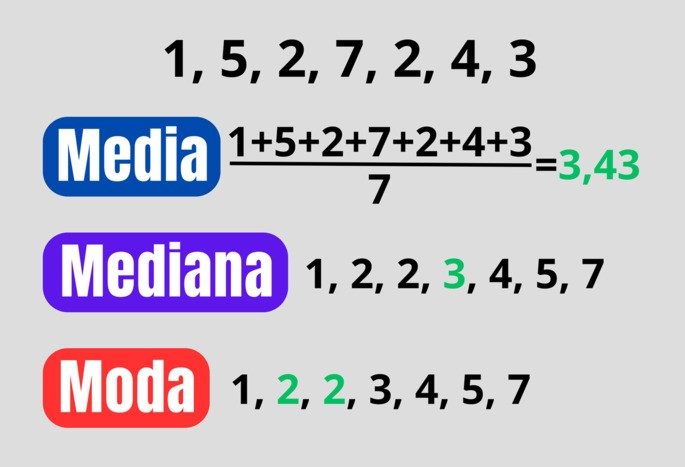
Statistieken kunnen een vreemde taal lijken totdat je ze opsplitst. De kern van data-analyse bestaat uit drie eenvoudige hulpmiddelen die u vertellen waar de dataset zich feitelijk bevindt. We noemen ze maten van centrale tendens. Ze beantwoorden de vraag: als je één getal zou moeten kiezen om al deze gegevens weer te geven, wat zou dat dan zijn?
Dit zijn niet alleen abstracte wiskundige concepten. Het zijn praktische manieren om patronen in chaos te vinden. Of u nu een leerling bent die naar een opdracht staart of een ouder die het rapport van uw kind probeert te begrijpen, weten hoe u het gemiddelde, de mediaan en de modus moet berekenen, maakt het verschil.
“Maatregelen van centrale tendens identificeren het centrum van een dataset. Ze laten zien waar de meeste waarden zijn geclusterd.”
Hier volgt een eenvoudig overzicht van deze drie verschillende variabelen.
Gemiddeld: wiskundig gemiddelde
Het gemiddelde is waar de meeste mensen aan denken als ze ‘gemiddeld’ horen. Het is de meest gebruikte maatstaf, maar ook de meest gevoelige voor uitschieters.
Om het gemiddelde te vinden, volgt u twee eenvoudige stappen:
1. Tel alle waarden in de dataset bij elkaar op.
2. Deel het totaal door het aantal toegevoegde getallen.
Als u vijf testresultaten heeft, tel ze dan allemaal bij elkaar op en deel ze door vijf. Het resultaat is het gemiddelde. Je krijgt een nauwkeurig wiskundig centrum, maar het kan vertekend zijn als de ene waarde aanzienlijk hoger of lager is dan de andere.
De mediaan: de middenweg
De mediaan is de werkelijke middenwaarde van de dataset. Het gaat niet om de grootte van de getallen, maar om de volgorde ervan. Dit maakt het een robuuste maatstaf als er uitschieters zijn die het gemiddelde kunnen vertekenen.
Om de mediaan te berekenen:
– Rangschik uw gegevens in oplopende volgorde (van klein naar groot).
– Zoek het exacte middelste getal.
Als u een oneven aantal gegevenspunten heeft, is de mediaan de enige middelste waarde. Als je een even getal hebt, bereken je meestal het gemiddelde van de twee middelste getallen. De mediaan splitst de reeks in twee gelijke helften. De helft van de gegevens ligt daarboven; de helft is naar beneden.
De modus: de meest voorkomende waarde
De modus is het eenvoudigste concept, maar kan ook het meest interessant zijn. Het is simpelweg de waarde die het vaakst voorkomt in uw dataset.
Een dataset kan het volgende bevatten:
– Eén modus (unimodaal)
– Twee modi (bimodaal)
– Meerdere modi (multimodaal)
– Helemaal geen modus (wanneer elke waarde slechts één keer voorkomt)
De modus is vooral handig voor categorische gegevens. Je kunt het gemiddelde van je favoriete kleuren niet berekenen, maar je kunt de modus wel gemakkelijk vinden. Het vertelt u wat het meest gebruikelijk of populair is in uw groep.
Waarom deze drie belangrijk zijn
Als u begrijpt hoe u het gemiddelde, de mediaan en de modus berekent, gaat het niet alleen om het slagen voor een test. Het gaat om het interpreteren van de wereld.
Stel je voor dat je naar de huizenprijzen in een buurt kijkt. Als één landhuis 10 miljoen dollar waard is en negen huizen 300.000 dollar waard, zal de gemiddelde prijs aanzienlijk stijgen. Het zou kunnen suggereren dat de buurt veel duurder is dan het in werkelijkheid is voor de gemiddelde koper. De mediaan zal echter dichter bij de $300.000 blijven, wat een realistischer beeld geeft van de typische huiskosten.
Het gemiddelde gebruikt elke waarde. De mediaan gebruikt gewoon
Kiezen tussen gemiddeld, mediaan en modus
De keuze tussen gemiddelde, mediaan en modus hangt volledig af van hoe uw gegevens worden gedistribueerd. Het gemiddelde werkt het beste als de gegevens zich in het midden bevinden, waardoor een accuraat beeld ontstaat van de algemene trend. Maar als de gegevens naar één uiterste afwijken, wordt het gemiddelde vertekend door uitschieters.
Wanneer waarden aan de uiteinden aanzienlijk verschillen van de rest, vertelt de mediaan of modus vaak een waarachtiger verhaal. Ze benadrukken wat feitelijk gebruikelijk is in uw steekproef of populatie. Houd er rekening mee dat de modus (de meest voorkomende waarde) overal in de gegevensset kan voorkomen, en niet alleen in het midden.
Laten we een kort voorbeeld bekijken om te zien hoe deze berekeningen werken. Stel je een fictieve ijssalon voor die de maandelijkse verkopen bijhoudt, ongeacht de smaak:
| Maand | IJsjes verkocht |
|---|---|
| Januari | 41 |
| Februari | 38 |
| Maart | 74 |
| april | 98 |
| Mei | 140 |
| Juni | 421 |
| Juli | 785 |
| Augustus | 723 |
| September | 506 |
| Oktober | 140 |
| november | 87 |
| December | 52 |
Om het gemiddelde te vinden, telt u alle verkochte ijsjes bij elkaar op en deelt u dit door het aantal maanden. Het resultaat is ongeveer 259 ijsjes per maand.
Hoe zit het met de mediaan? Sorteer eerst de waarden van klein naar groot:
38 < 41 < 52 < 74 < 87 < 98 < 140 < 140 < 421 < 506 < 723 < 785
Omdat er een even aantal gegevenspunten is, neemt u de twee middelste waarden: 98 en 140. Bereken hun gemiddelde om de mediaan te krijgen, namelijk 119.
Ten slotte is de modus eenvoudigweg de herhaalde waarde. Hier is het 140, omdat het twee keer voorkomt terwijl geen enkel ander getal wordt herhaald.
Hoe het gemiddelde wordt berekend
Het gemiddelde is het rekenkundig gemiddelde van een reeks getallen. Omdat het rekening houdt met elk afzonderlijk datapunt, is het zeer gevoelig voor uitschieters: die extreme waarden die ver verwijderd zijn van de rest.
Het berekenen ervan is eenvoudig:
- Verzamel alle gegevenspunten uit uw monster. Je hoeft ze niet eerst te sorteren.
- Som alle gegevenswaarden op.
- Deel dat totaal door het aantal datapunten.
Merk op dat deze berekening numerieke gegevens vereist. U kunt geen gemiddelde berekenen voor categorische gegevens zoals kleuren of namen.
Beschouw een ander voorbeeld: het volgen van de frisdrankconsumptie onder tien mensen.
| Persoon | Frisdranken geconsumeerd |
|---|---|
| Een | 5 |
| B | 4 |
| C | 8 |
| D | 5 |
| E | 16 |
| F | 0 |
| G | 10 |
| H | 9 |
| ik | 20 |
| J | 1 |
Het optellen van deze waarden levert 78 op. Met 10 mensen in de steekproef levert het delen van 78 door 10 een gemiddelde van 7,8 frisdranken per persoon op.
Kijk nu eens hoe uitschieters dit resultaat vertekenen. Stel je de top tien doelpuntenmakers van een voetbalteam voor:
| Speler | Doelen |
|---|---|
| Een | 2 |
| B | 3 |
| C | 4 |
| D | 4 |
| E | 5 |
| F | 6 |
| G | 8 |
| H | 9 |
| ik | 12 |
| J | 50 |
De som bedraagt 103. Delen door 10 spelers geeft een gemiddelde van 10,3 doelpunten. Het lijkt misschien logisch om te zeggen dat de gemiddelde speler 10,3 doelpunten scoort. Maar dat is misleidend. In werkelijkheid zitten slechts twee spelers boven dat gemiddelde. De meerderheid scoort minder dan 10.
Het gemiddelde is niet altijd het beste instrument om het gedrag van een populatie te begrijpen. Het schittert wanneer gegevens gelijkmatig worden verdeeld. Als er sprake is van scheefheid, heb je een ander perspectief nodig.
Waarom mediaan en modus belangrijker zijn bij scheve gegevens
De mediaan vertegenwoordigt het middelpunt van een gegevensset. Het splitst uw gegevens in tweeën: 50% van de waarden is lager, 50% is hoger. Omdat het afhankelijk is van positie in plaats van omvang, negeert het de werkelijke afstand tussen waarden. Dit maakt het robuust tegen extreme uitschieters.
In het ijsvoorbeeld lag de mediaan (119) veel dichter bij de typische maandelijkse omzet dan het gemiddelde (259). De enorme pieken in de zomer trokken het gemiddelde omhoog, waardoor een verkeerde indruk ontstond van hoe een ‘standaard’ maand eruit ziet. Als u een bedrijf runt, helpt de wetenschap dat 119 een realistischer uitgangspunt is bij de voorraadplanning. Het gemiddelde kan ertoe leiden dat u tijdens de langzamere maanden een overschot krijgt.
De modus voegt nog een laag van inzicht toe. Het identificeert de meest populaire uitkomst. In de verkoop is dit vaak praktischer dan gemiddeld. Als 140 eenheden het meest voorkomende verkoopcijfer is, is dat een opmerkelijk patroon. Het vertelt je wat klanten feitelijk het vaakst doen, niet wat het wiskundige centrum suggereert.
Overweeg een scenario waarin u de oplossingstijden voor klantenondersteuningstickets analyseert. De meeste tickets duren twee dagen. Bij enkele duurt het twee weken vanwege complexe vraagstukken. Het gemiddelde zou 4 dagen kunnen zijn. De mediaan kan 2 dagen aangeven. De modus is zeker 2 dagen.
Welke is nuttiger?
Als u de verwachtingen van de klant bepaalt, is de mediaan of modus beter. U wilt geen vier dagen beloven terwijl de meeste mensen binnen twee dagen hulp krijgen. Het gemiddelde verbergt de realiteit van uw standaard serviceniveau.
De modus heeft echter zijn grenzen. Wat als elke waarde uniek is? Dan is er geen modus. Of wat als er meerdere modi zijn? Een dataset kan bimodaal zijn, met twee gemeenschappelijke waarden. Dit kan duiden op twee verschillende klantgroepen of productvoorkeuren. In dergelijke gevallen benadrukt de modus segmentatie in plaats van een enkele centrale tendens.
Voor numerieke gegevens is de mediaan altijd gedefinieerd, op voorwaarde dat u deze kunt ordenen. Het is dé oplossing voor de inkomensverdeling, huizenprijzen of welke dataset dan ook waarbij een paar extreme waarden het gemiddelde zouden vertekenen.
Dus, wanneer moet je welke gebruiken?
Gebruik het gemiddelde voor symmetrische verdelingen met weinig uitschieters. Denk aan testscores in een goed uitgebalanceerde klasse of productietoleranties.
Gebruik de mediaan als gegevens scheef zijn of uitschieters hebben. Denk aan inkomen, huizenprijzen of responstijden.
Gebruik de modus voor categorische gegevens of om de meest voorkomende gebeurtenis in een gegevensset te vinden. Denk aan favoriete kleuren, favoriete betaalmethoden
Hoe u de mediaan van een dataset kunt vinden
De mediaan is de middelste waarde in een geordende lijst. Het is een statistisch hulpmiddel dat een dataset doormidden snijdt. In tegenstelling tot het gemiddelde laat het niet toe dat extreme afwijkingen het resultaat vertekenen. Dit maakt het betrouwbaar voor inkomensgegevens of testscores waarbij een waanzinnig hoog getal het gemiddelde vertekend.
Om het te vinden, moet je een strikt proces volgen. Verzamel eerst uw numerieke gegevens. Sorteer vervolgens. Bestel hier is belangrijk. Noem de getallen van klein naar groot of van groot naar klein. De richting verandert het centrum niet. Zoek na het sorteren het midden.
De methode verandert afhankelijk van of u een even of oneven getal heeft. Als de dataset een oneven aantal elementen bevat, is de mediaan de enkele waarde precies in het midden. Als het even is, heb je de middelste twee cijfers. U krijgt het gemiddelde van deze twee waarden. Dat is het. Simpele logica.
Laten we eens naar een concreet voorbeeld kijken. Stel je voor dat je de tv-verkopen van zeven modellen bijhoudt.
| Model | Verkoop |
|---|---|
| EEN | 104 |
| B | 67 |
| C | 122 |
| D | 176 |
| E | 81 |
| F | 130 |
| G | 75 |
Sorteer eerst de verkoopcijfers:
67, 75, 81, 104, 122, 130, 176
Er zijn zeven waarden. De vierde bevindt zich in het midden. De mediaan is 104. Waarom? Omdat er drie cijfers onder en drie boven zijn. Het zit precies in het midden.
Wat gebeurt er als u nog een tv-model toevoegt? Laten we zeggen Model H, waarvan 150 exemplaren zijn verkocht. De nieuwe lijst ziet er als volgt uit:
67, 75, 81, 104, 122, 130, 150, 176
De telling is nu gelijk. Acht artikelen. Er is niet één middengetal. Je hebt er twee: 104 en 122. Neem het gemiddelde van de twee.
104 + 122 = 226
226/2 = 113
De nieuwe mediaan is 113. Deze weerspiegelt de verandering in de gegevensverdeling.
De modus identificeren: van cijfers tot categorieën
Modus is anders. Het is de meest voorkomende waarde. De grootte van de getallen doet er niet toe. Het draait allemaal om herhaling. Dit maakt het uniek omdat het ook met niet-numerieke data werkt. U kunt de modus van oogkleuren, favoriete voedingsmiddelen of automerken vinden.
Een dataset kan geen modus hebben. Het kan er een hebben. Of het kan er veel zijn. Terminologie verandert met de frequentie.
* Unimodaal: Eén waarde komt het vaakst voor.
* Amodal: Geen waardeherhalingen. Elk artikel is uniek.
* Bimodaal: Twee waarden delen de piekpositie van de frequentie.
* Multimodaal: Meer dan twee waarden resulteren in de hoogste frequentie.
Bereken het eenvoudig door de gebeurtenissen te tellen. Groepeer de herhaalde gegevens. Kies de groep met het hoogste nummer. Dit is de modus.
Overweeg om tien gezinnen en hun autobezit te onderzoeken.
| Familie | Auto’s |
|---|---|
| EEN | 1 |
| B | 3 |
| C | 1 |
| D | 2 |
| E | 2 |
| F | 4 |
| G | 2 |
| H | 1 |
| ik | 2 |
| J | 3 |
Tel de frequenties:
* 4 auto’s: 1 gezin
* 3 auto’s: 2 gezinnen
* 1 auto: 3 gezinnen
* 2 auto’s: 4 gezinnen
Nummer 2 komt het meest voor. De modus is 2. De meeste gezinnen in deze steekproef bezitten twee auto’s.
De modus schittert met categorische gegevens. Kijk eens naar een onderzoek naar de favoriete kleuren van kinderen.
| kind | Favoriete kleur |
|---|---|
| EEN | Groen |
| B | Rood |
| C | Blauw |
| D | Groen |
| E | Wit |
| F | Roze |
| G | Paars |
| H | Groen |
| ik | Blauw |
| J | Blauw |
Tel de kleuren:
* Groen: 3 keer
* Blauw: 3 keer
* Rood, Wit, Roze, Paars: elk 1 keer
Groen en blauw delen de eerste plaats. Dit is een bimodale verdeling. Zowel groen als blauw zijn de modi. Dit inzicht vertelt je iets dat de mediaan of het gemiddelde je nooit zou kunnen vertellen: er is niet één enkele ‘gemiddelde’ voorkeur, er zijn slechts twee dominante keuzes.